谷歌在今天正式发布了新一代的前沿模型, 也就是 4 , 谷歌方面称这是目前能力最强的模型, 把网络安全防御和长周期任务能力列为重点,这次发布距离上一代 4 Argon 上线仅仅只有两周。
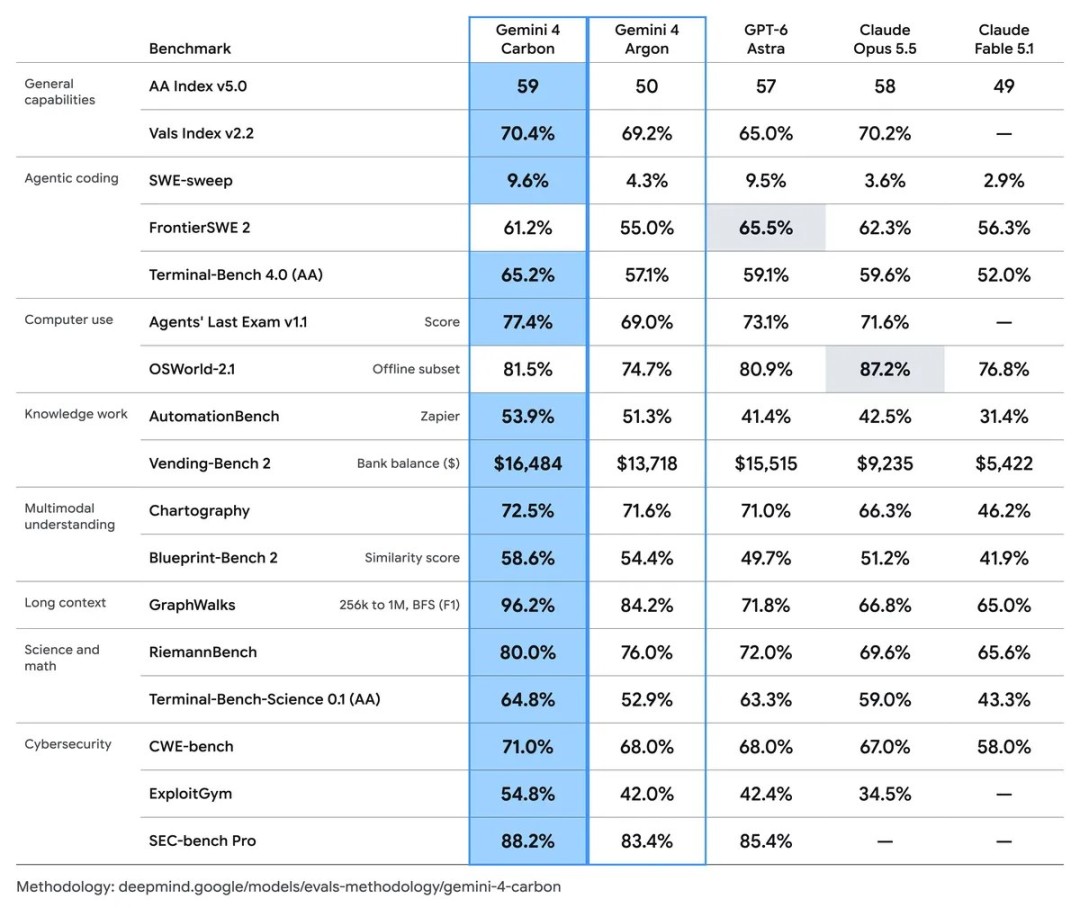
根据更新了的内容来算, Index v5.0 这个项目上的得分是 59, 并且排在了第一名的位置。
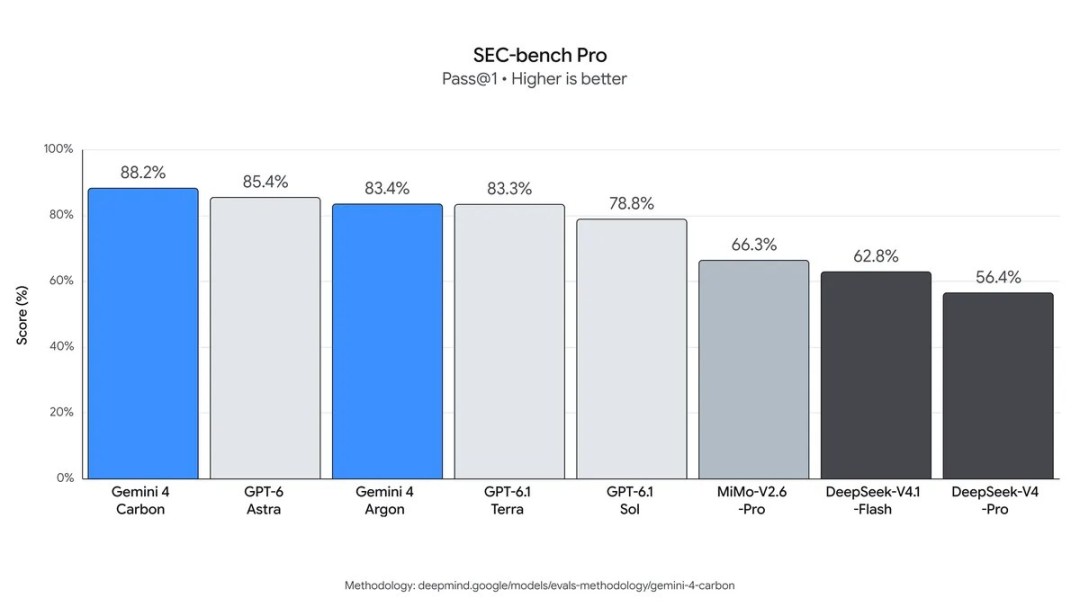
谷歌这边公开了三条关于网络安全基准的测试成绩, 其中漏洞发现 SEC-bench Pro 这一项拿到了 88.2% 的成绩, 漏洞可利用性验证这一块是 54.8%, 根因修复 CWE-bench 这一项则是 71.0%, 这些分数表现出的水平都已经达到了目前最优的标准了。
在 Arena 这个地方, 它的得分相比于之前的版本来说, 提高了 89 elo, 最终到达了一千七百六十八分的成绩, 并且排在第四名的位置。
谷歌进行的内部测试表明, 生成安全代码的成功率已经提升到了Argon模型的两倍以上。团队方面声称, 其系统在生成高质量补丁这一指标上的表现比另外一家实验室所推出的大型前沿模型要好出十几倍。
云安全平台Wiz则表示自己在这个Web渗透测试基准上处于领先地位。它是专门为了那些需要长时间运行的智能体工作流而设计的。谷歌内部曾经让它连续运行了好几天, 在大型代码库和底层系统里寻找并且修复细微的缺陷。
这套防护措施沿用了名为的系统中的多层防护机制, 这其中的防护机制包含模型训练阶段的处理、实时滥用行为的防御措施、对抗提示注入的应对能力以及针对思维链环节的监控工作。
谷歌方面声称, 在使用-Bench 4.0这一标准进行测试时, 系统表现出成功被作弊的概率降低到了百分之零, 而且进行作弊尝试的次数也下降到了百分之零点四。公司方面还观察到, 内部属于高危级别的对齐错误告警数量大幅度减少, 具体减少了将近八成的比例。
此外, 那些缺乏依据便得出的结论数量, 相对于–模式下的情况而言, 大约减少了一半左右。在Gray Swan这个间接性提示注入基准里头, 那个攻击的成功率是从Argon的0.7%, 直接下降到了0%。
另外, 因为那种过度的干预做法所减少的量占了29%, 而服务不足的情况所减少的量, 则是26%。
谷歌针对 的投放打算采取分阶段推的方式进行。从这周开始先向一小部分的网络安全防御人员开放。之后通过 来逐步把范围扩大。然后再向开发者、企业和消费者提供服务。但是具体的时间安排还没有给出。关于的定价, 继续采用跟 Argon 一样的引入期标准。
具体来说, 每百万个输入 token 的价格是 2 美元, 输出 token 的价格是 10 美元。对于缓存起来的输入内容, 会按照输入价格打 95% 的折扣来进行计费。等到引入期结束以后, 就会把价格调整成 4 美元和 20 美元。