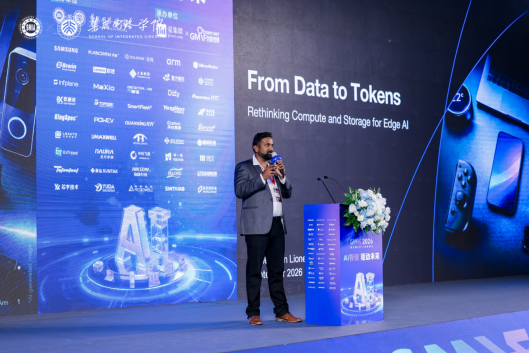
在9月23日这一天, Arm公司在GMIF 2026全球存储器行业创新峰会这个场合里, 抛出了一个判断, 这个判断的内容是说, 关于边缘AI领域的下一个瓶颈或者卡点, 问题并不在于算力本身, 而是取决于存储能力。
这一番话要是被现场那些专注于做芯片、或者是从事存储方案制定的人听到了, 他们心里可能就不太乐意了, 甚至会坐不住。
AI推理把存储逼成第一瓶颈
John在演讲里点明了一个事实, 在大模型推理的解码阶段, 系统需要反复读取KV Cache, 这时候内存的容量和带宽就直接决定了吞吐量是多少, 在过去大家只是拼算力就可以了, 但是现在算力强并没有用, 如果数据喂不进去, 那也是白搭。
他举出了一个具体的数字,这个数据是说有一百万台设备, 在这台设备上每天要完成二十次的AI交互动作, 每一次交互都会生成五百个Token, 那么把这些加起来算一下, 一天产生的Token总数就是十亿个。
要知道每一个Token的背后都关联着计算资源、内存占用、存储需求以及网络带宽和电费支出这些成本, 这意味着推理环节的工作性质已经不再是一次性的前期投入了, 而是演变成了一种持续不断地消耗资金的形态。
Token成了AI的隐形运营成本
过去那些企业在计算人工智能相关费用, 看的是进行模型训练的时候一共耗费了多少钱。现在企业把技术进行规模化的部署之后, 每天产生的Token数量反而占据了主要部分。
John认为, 整个产业界应该去问一个核心问题, 不再是能生成多少Token, 而是要考虑用什么尽可能低的成本来生成具有实际价值的智能内容。
这也就是说, 人工智能方面的运营工作, 从那种资本性的开支, 变成成了日常运营的开支, 财务方面的逻辑全都改变了。对于那些做存储业务的人来说, 客户的问法不再是怎么问这一颗芯片究竟需要花费多少钱了, 而是开始问这一套方案每天能够帮助自己节省多少电力的消耗, 以及能够减少搬运多少数据的工作量。
分布式AI让每个位置都有合适活干
John把AI工作负载按层级分得很清楚, 唤醒词检测和异常报警留在终端本地跑, AI助手和多模态交互放在手机、PC和XR上, 行业模型跑在边缘服务器, 超大模型和训练还在云端。
这样做的好处在于, 能够让用户的请求响应得更快, 同时确保数据不会离开设备本地, 并且还能够节省电费。
最关键的问题并不在于要把所有的工作任务全部堆积在云端服务器上, 也不在于把所有的工作任务全都塞到终端设备上, 而是要让每一块具体的工作任务, 都能够准确地落在那个能够在功耗、时延、隐私保护以及成本支出方面都最为合适的层级上面。
存储从仓库变成智能仓库
在过去, 存储干的事情其实是很简单的, 就是用来存系统、用来存应用、用来存用户文件。
但是现在不行了, 模型权重需要长期留在设备里, 向量数据库需要长期留在设备里, 本地知识库需要长期留在设备里, Agent的记忆也需要长期留在设备里, 存储在设备里装的东西, 现在不只是数据, 存储里的东西是智能本身。
这就产生了一个非常硬的约束条件。NPU算力再强, 如果数据在存储、内存和计算单元之间无法快速通行, 整体 performance 照样会卡住不动。对于边缘AI来说, 对存储的要求已经不是仅仅升级容量了, 还必须同时考虑带宽、加载速度、安全隔离以及功耗管理, 这些因素全都必须放在一起综合计算。
十亿参数跑在边缘 Arm亮出新牌
这次, Arm推出了Armv9平台, 在这个平台上, 使用了Cortex-A320来配合Ethos-U85 NPU。
其中的思路是非常直接的, 也就是让数据紧挨着计算单元进行传输, 让模型保存在Flash里面, 然后由NPU根据实际的需求来进行调用。其设立的目标, 就是要让拥有10亿参数规模的模型, 能够得以在边缘设备上运行起来。
针对那些注重低功耗的设备终端, 其实使用Arm-M架构的中央处理单元就已经完全足够使用了, 其核心原则就是尽最大的能力去减少对外部数据的频繁读取与写入操作。
而对于需要运行大型人工智能模型的设备, 比如智能个人电脑以及机器人产品来说, 就必须依赖于Cortex-A320处理器与非神经网络处理单元的协同工作。
John先生所表达的观点是非常明确的, 也就是说在计算领域, 无论是从最追求省电效果的个人终端设备出发, 一直到具有较高性能表现边缘计算领域, Arm架构公司都希望能够实现全面的覆盖。
下一场竞争不是算力是系统协同
John最后把话收拢得非常确切, AI时代的竞争情况, 现在已经完全不在于单纯地去比较谁的TOPS数值更高了, 而是重点去看计算单元、内存存储系统以及数据移动这个操作, 它们三者能不能真正地咬合在一块儿。
Arm推出的那种异构架构的目的就是为了使得上述这四个关键环节在实际运转过程中能够减少彼此之间产生的摩擦和冲突, 同时增加相互配合的默契程度。
对于那些从事存储方案工作的人员而言, 这意味着客户将使用系统级能效这一概念来对你提出相关的要求, 他们不再会仅仅只去关注某一类特定芯片的带宽数据这一单一指标。
在实际业务过程中, 究竟是谁能够为协助客户达成整条数据通路的顺畅运行与流畅处理, 那么谁就能够去获得由下一波边缘人工智能技术带来的巨大市场红利与发展机会。
你现在手上的这些存储在数据处理方面的办法, 是不是已经全都准备妥当, 可以完全应付那些拥有十亿参数的大型模型所产生的海量数据了? 如果你心里也是这样想的话, 那么就去评论区里说一说自己的看法。如果你觉得这段话是有用的, 那就点个赞支持一下, 然后再把它转发给你的同行为工作伙伴看看。