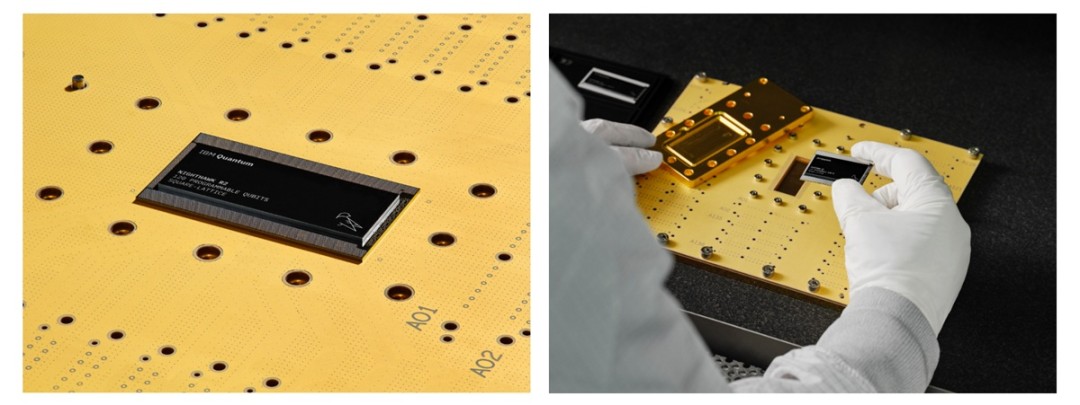
IBM宣布, 推出 r3, 这是新一代的量子处理器。其支持在520个量子比特上执行1万次的量子运算。它可实现规模更大的计算任务。它也实现更复杂的计算任务。
这助力IBM推进其量子处理器的发展路线图。IBM计划明年将两个 r3连在一起。目的是组成一个拥有超过1000量子比特的系统。目的进一步提高性能上限。
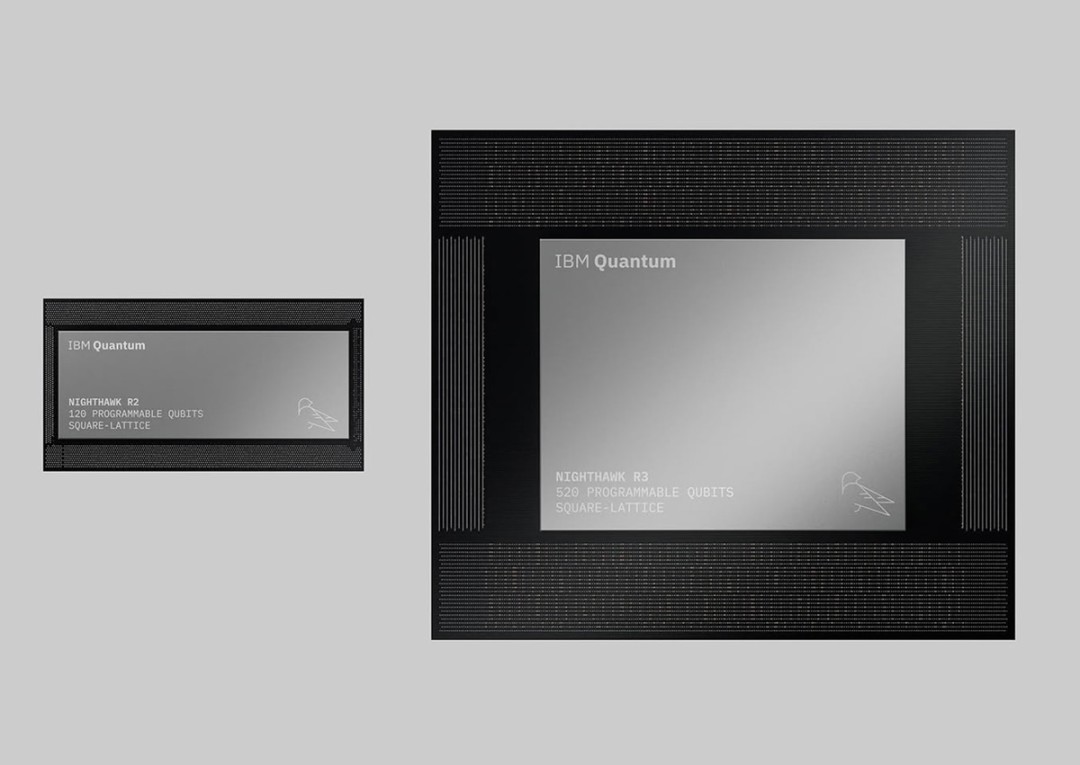
IBM这个企业, 就在今年9月的那个时候, 把r2这个东西给推出来了。它支持在120个量子比特上面执行7500次量子运算这一类事情。它的这个高速量子比特重置技术, 这个东西很厉害, 它把电路执行之间的间隔时间给显著地缩短了。
正是因为间隔时间变短了, 所以使得各种应用程序能够更加高效地去收集那些必须用来进行复杂计算的样本数据。这些需要收集的样本数据的数量会达到数百万甚至数十亿个之多。
包括 E.ON 在内的客户, 还有 Q-CTRL 这样的合作伙伴, 他们使用了 r2。他们在 r2 上已经执行了超过 340 亿条电路。报告里面提到了这个情况。报告说速度提升了。和 IBM 以前的量子处理器相比, 速度提升最高能达到 19 倍。
在后续阶段, IBM把一项本来是用来用那种混杂了不同类型结构的量子材料做模拟测试的实验, 扩展到了所谓的r2这个地方, 这样一来就让电路执行的速度相比原来的那个实验变快了八倍之多。
r3在 r2的根底之上, 把高速架构扩大到了更大规模的量子计算机那里去, 它一共能够处理2034个物理量子比特。它在保留 r2的方形晶格连接和快速运算能力的那个同时情况下, 又引入了10个芯片间互连, 这种互连被叫做 l 型耦合器, 通过这种方式, 将处理器连接成了一个更大的系统。
另外, IBM在今年还完成了两项关键技术的验证工作, 这让模块化量子计算变成了现实有可能实现的事情, 同时也让人们对于未来能够把系统扩展到更大规模的量子计算机上去这件事情, 变得更加有信心了。
IBM 利用四个 L 型的耦合器把 r1 给连接起来了, 这样实现的量子态传输保真度达到了百分之九十九点三, 并且还朝着百分之九十九点九的目标去努力了, 而 IBM 也把两个低温模块第一次整合到了同一个装置里面去了, 整个过程用了不到五天的时间就让系统达到了工作状态, 然后再把温度冷却到了低于十五毫开尔文的位置上。
最近, IBM和橡树岭国家实验室, 还有AMD他们三个单位合作, 推出了一个全新的量子纠错协同设计平台。这个平台接下来会被安装在橡树岭国家实验室那边的那个Umbra高性能计算系统里面去。它整个运行的时候呢, 是靠AMD的GPU, 再加上第五代EPYC CPU这些硬件来提供强力支持的。